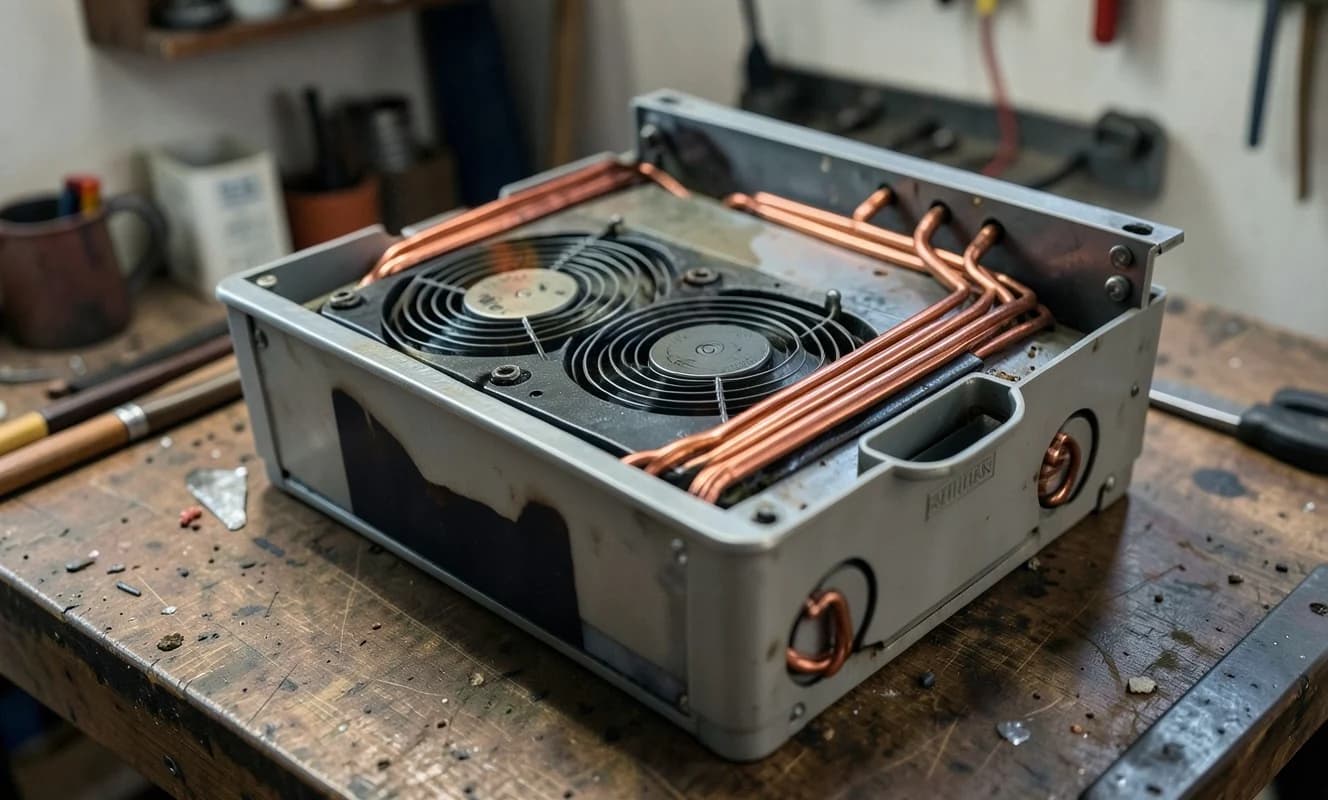
Bir bilgisayar meraklısı, yerel LLM çıkarımları için çok gürültülü ve neredeyse kullanımdışı bir kurumsal GPU'yu yeniden kullanarak, 32GB VRAM ile 27 milyar parametreli bir modeli 32 token/saniye hızında çalıştırabilen bir sistem oluşturdu. Bu, 266 dolar ek maliyetle gerçekleştirildi.
Oscar Molnar, 16GB HBM2 ile ucuz bir Tesla V100 SXM2 ve SXM2'den PCIe'ye bir adaptör satın alarak, VRAM'sını 32GB'a çıkardı. Ayrıca, çimen kosa kadar gürültülü soğutucu için bir PWM modu da ekledi. Bu GPU'lar şu anda ucuz görünüyor, eBay'da Çin'den almak istemiyorsanız, her biri 140 dolardan daha az bir fiyata listeleniyor.
Tesla V100 SXM2 kartını doğrudan PC'ye takmak mümkün değil. Molnar, eBay'da 66 dolar harcadığı bir SXM2'den PCIe'ye adaptör satın aldı. Ancak, 'cehennemden gelen fan' olarak tanımlanan soğutucunun gürültüsü, PC ve yerel LLM meraklısını rahatsız etti. Bu soğutucu, 82dB gürültü çıkardı ve Molnar, bu sesi 'çöp ezici ile çimen kosa arasında' olarak tanımladı. Bu, en karmaşık ayar olabilir, ancak aslında mevcut fan kablolarının yeniden yönlendirilmesi ve anakartın PWM fan başlığına takılması gerekiyordu. Ayrıca, bu işlem için '2.54mm erkekten PH2.0 dişi jumper kablo' da satın alınabilir. Fanın sadece %10 hızında çalışması, Tesla V100'ün tam yükte 50C altında kalmasını sağlıyor.
32GB VRAM ile donatılmış sistem, RTX 4080 (16GB VRAM, Ada mimarisi) ve Tesla V100 (16GB VRAM, Volta mimarisi) ile çalışıyor. 32GB VRAM'lı Tesla V100'ler, iki katı fiyata satılıyor. Molnar, NixOS ve eski bir Nvidia sürücüsü kullanarak, Volta ve Ada mimarilerini destekleyen bir sistem oluşturdu. Yerel LLM testleri sırasında, 27 milyar parametreli bir modeli 32 token/saniye hızında çalıştırdı, bu da 'etkileşimli kullanım için yeterince hızlı' ve çoğu bulut API alternatifinden daha hızlıdır.