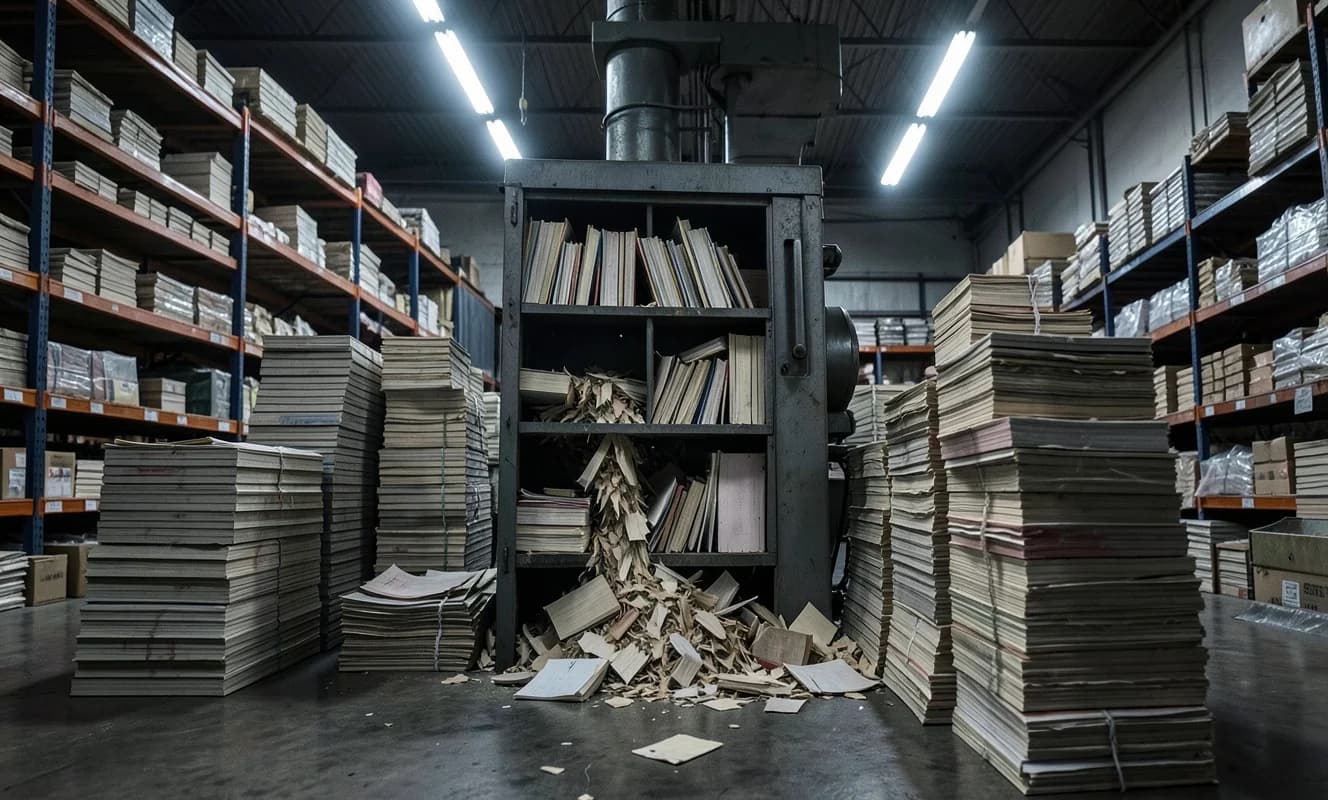
Bir büyük e‑ticaret şirketinin dağıtım merkezinde görev yapan bir çalışan, fiziksel kitapların taranıp ardından imha edildiğini ve bu metinlerin şirketin yapay zekâ ürünlerini geliştirmek için toplandığını belirtti. Açıklama, bir podcast programında yapılan bir röportaj sırasında ortaya çıktı.
Tarama işleminden sonra kitaplar bir endüstriyel parçalama makinesine yönlendirilerek yok edilir; elde edilen dijital metinler, büyük dil modellerinin eğitimi için geniş bir veri havuzu oluşturur. Şirket, bu uygulamayı resmi olarak doğrulamadı ve çalışan, sürecin şirket içi bir veri toplama programının parçası olduğunu söyledi.
Uzmanlar, telif hakkı korumalı eserlerin izinsiz olarak yapay zekâ eğitiminde kullanılmasının yasal ve etik sorunlar doğurabileceğini vurguluyor. Yayıncılar ve yazarlar, eserlerinin kontrolünü kaybetme riskiyle karşı karşıya ve düzenleyicilerin veri toplama yöntemlerine daha fazla dikkat etmesi bekleniyor.